2026 年 10 月 30 日,腾讯全球数字生态大会的一个专场上,腾讯乐享发布了两样东西:企业可信索引,和 AI 巡检。
名字都不性感。一个讲怎么 AI “找对”知识,一个讲怎么让知识“别过期”。放到发布会上,远不如一个能说会道的聊天框抓眼球。
但如果把时间线拉长来看,这其实是同一件事的最新一步:这个 2008 年从腾讯内网长出来的知识管理工具,正在把它的服务对象,从人换成 Agent。
笔者第一次真切感觉到这个变化,是在自己电脑上。WorkBuddy 里挂上乐享的 Skill 之后,写东西时不用再去翻知识库——不是我去找它,是它在我干活的地方把材料递过来。
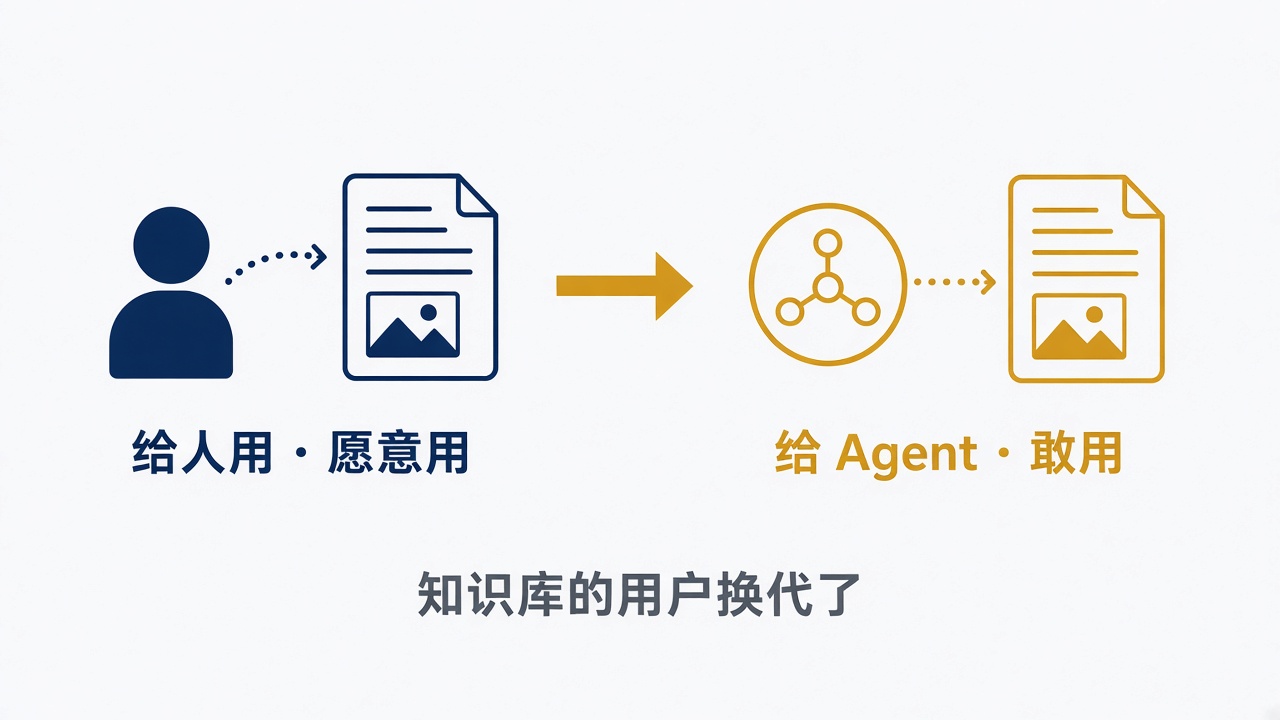
以前我们问的是“知识库怎么让人愿意用”,现在问的是“知识库怎么让 Agent 敢用”。这两个问题,差着整整一代产品。
一、2008:那个被叫作“鹅厂知乎”的地方
2008 年,腾讯内网的 KM 诞生。员工在上面分享技术心得、产品经验,也可以说对公司的意见——实名行,匿名也行。
因为足够开放,它后来被叫作“鹅厂知乎”,是不少人离职后最怀念的一项“福利”。有一组老数据:腾讯员工在 KM 上分享过超 50 万篇知识,每月上万名员工在“乐问”里参与公司的大事小情,每天 70% 的员工会访问它。
这个阶段的乐享,关键词是“愿意写”。
笔者一直觉得,知识管理最难的一步从来不是“存”。硬盘很便宜,网盘更便宜,难的是有人肯把脑子里的东西掏出来、写成别人看得懂的样子。腾讯当年解决这个问题靠的不是技术,是文化——鼓励分享、允许争吵、接受匿名吐槽。
《腾讯创始人 Tony 对谈》那篇访谈在内部引起过热议,张志东在里面讲,好的团队要允许不同意见。这种东西没法写进产品文档,但它恰恰是 KM 能活下来的原因。
二、2017:把“鹅厂的味道”打包卖出去
2017 年,乐享全面对外开放。脱胎于 KM,名字取“乐于分享”,第一批接入 3000 多家企业,其中有可口可乐、链家、中国移动这样的名字。到 2025 年,这个数字变成了 30 多万家。
当年卖的是什么?文档、K 吧、乐问、课堂、考试、活动、投票、论坛——一堆组件拼起来的一站式企业社区。
说白了,卖的不是软件,是腾讯那套“扁平沟通”的文化和十来年的管理经验。这在当时是个很讨巧的定位:别的厂商卖功能,腾讯卖“我们自己也这么干”。
但笔者想指出这一代知识库的一个隐含假设:知识是给人看的,人看完会自己用起来。
这个假设维持了十几年,一直没人怀疑。直到大模型来了。
三、AI 来了,知识库第一次真被“用”起来
2025 年 6 月,腾讯披露了一个内部案例,笔者印象很深。
腾讯云的产品线太杂——服务器硬件、B 端软件、前台销售、后台运维,知识散在不同团队。新人上手难度大到什么程度?不少人“入门即放弃”。乐享给他们做了个专属知识库,叫“云知”,把散落的 10 万余份行业经验文件重新梳理成体系,接上大模型做问答、摘要和内容生成。
上线之后的数据:年访问量 800 多万次,70% 的销售和架构师每周都会用,一年在时间、人力、场地上省下近 3 亿元。
笔者看重的是另一个数:70% 的销售和架构师每周在用。
这个数字说明知识库的用户变了。以前它更像新人培训的仓库,一年打开两次;现在它是一线打仗时的弹药库。同样一个库,接上大模型之前是档案室,接上之后是参谋部。
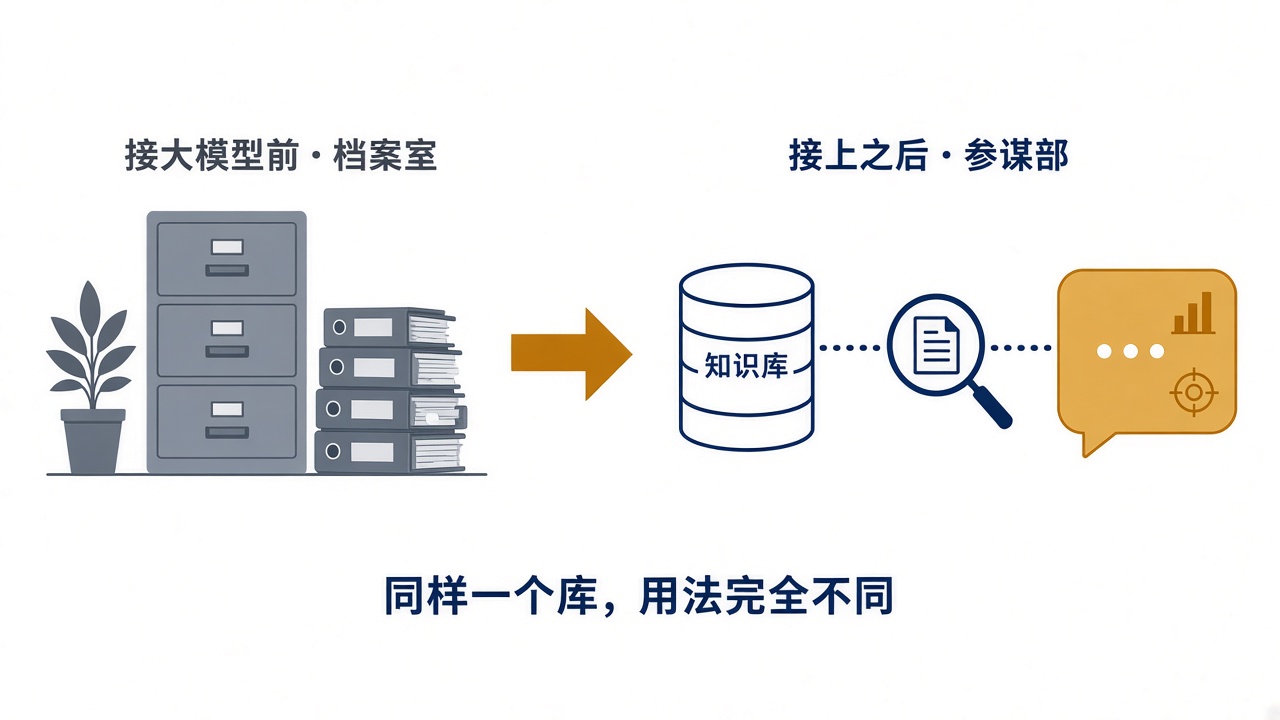
技术上讲这件事并不复杂:把大模型接上 RAG(检索增强生成,就是让 AI 先翻文档再回答),再让它按 ReAct 的方式边推理边调工具。检索负责“找到”,模型负责“说人话”。就这两步,把一个躺了十年的知识库盘活了。
四、2026:用户从人变成了 Agent
真正的转折发生在今年。
6 月 5 日,腾讯云 AI 产业应用大会上,乐享把产品定位从“企业知识管理平台”改成了“企业 Agent 知识中枢”。同一天,它和 WorkBuddy 企业版完成深度集成,在腾讯的办公智能体套件里承担“组织记忆”这个角色。
接着是一串密集动作:7 月 2 日武汉峰会,升级统一纳管、智能治理、深度加工、安全开放四大能力;7 月 18 日 WAIC,接入十余种知识来源,支持全量导入、增量同步、实时检索三种模式,103 种格式可被 AI 深度解析,单文件上限 10GB。
把这些拼起来看,逻辑很清楚:以前是企业里每个助手各喂一遍知识,现在是一套知识供给 N 个 Agent。
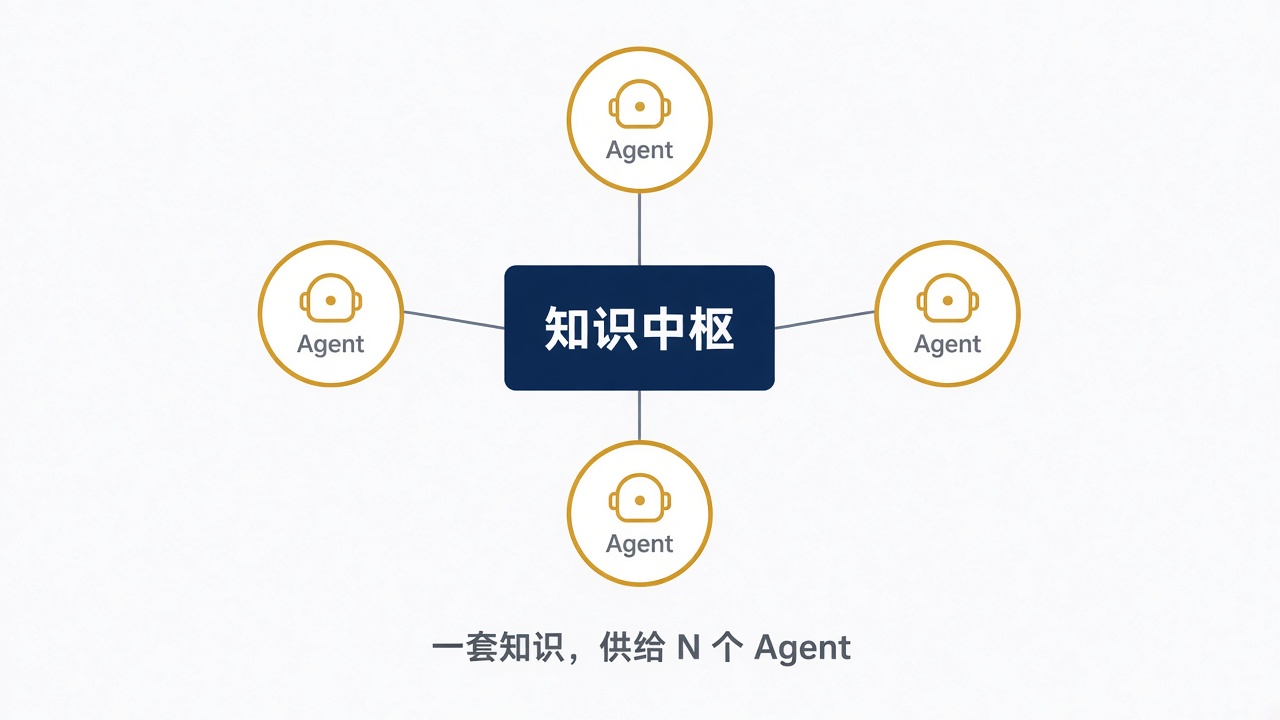
笔者在《DeepSeek Harness:当 Agent 的一切都能拆成插件》里写过,Agent 这两年真正的分水岭不是模型变强,而是它有了“手”——能挂 MCP、能调工具、能读你公司自己的库。乐享这次干的活,就是给这些“手”准备弹药。这跟当年给员工一个 KM,是同一套逻辑的两次落地。
乐享总经理周芝芝有句话说得挺直白:越是聪明的智能体,越需要一个可信的、可治理的、干净的知识库。
笔者认同,而且想补一句更狠的:智能体越笨,越需要一个干净的知识库。因为它笨的时候不会质疑你给的材料,你喂什么它信什么。
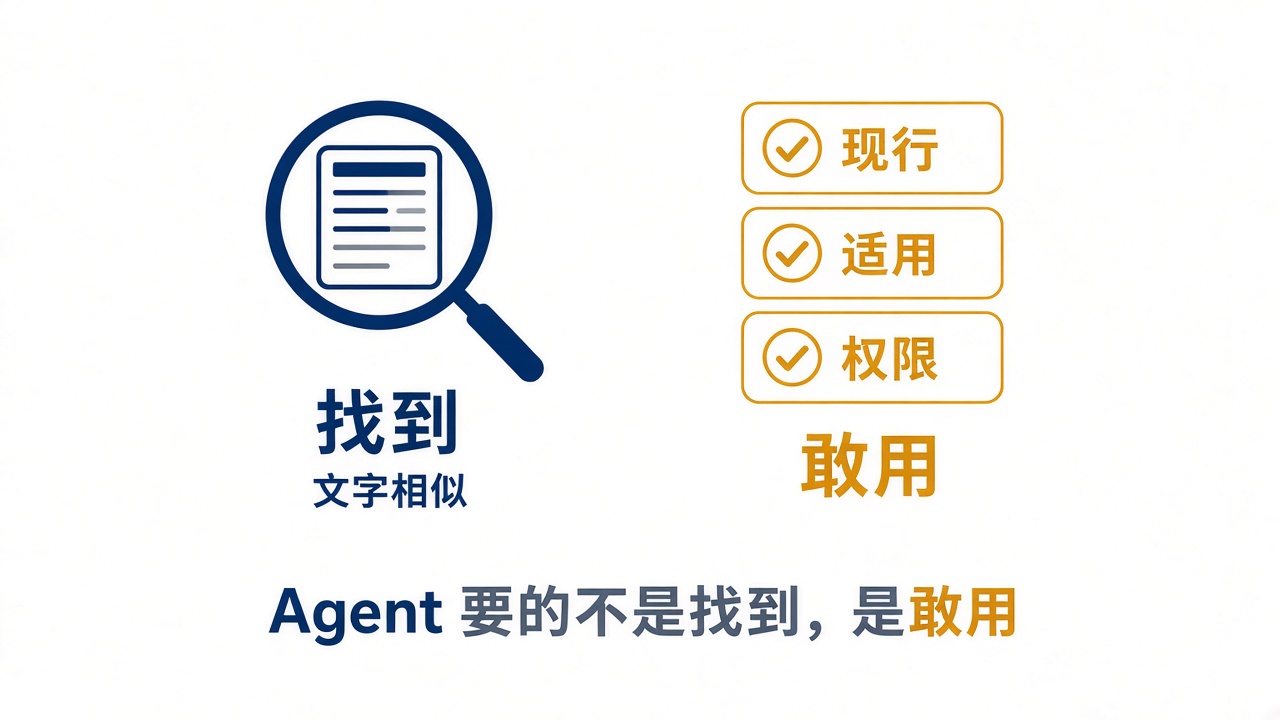
五、Agent 要的不是“找到”,是“敢用”
这里有个槛,很多人低估了。
RAG 的老毛病是:它擅长找“文字上相似”的段落,不擅长判断“这段话现在还作不作数”。同一款产品在不同版本、不同地区、不同时间适用不同规则;一次设备故障的处理依据,可能同时散在操作手册、维修规范、历史工单和专家复盘里。
AI 要能干活,光“找到”远远不够,它得知道哪份是现行版本、什么条件下适用、这个用户有没有权限看。
乐享 10 月 30 日给的答案,是做“可信索引”——说白了,就是让 AI 开口之前先搞清楚:这知识属于谁、管什么事、还算不算数。做法是把本体、知识图谱和 LLM Wiki 捏在一起:本体定义业务对象的属性和规则,图谱连起跨文档的实体线索,Wiki 把多源材料揉成一段带依据、能读也能维护的表达。再配上 AI 巡检,持续排查库里重复、冲突、过期的内容。
这里有个细节笔者觉得比功能本身更值得看:巡检发现口径冲突,不让 AI 自己去定哪条规则生效,而是推给责任人确认修改。知识治理这件事一旦交给 AI 自动改,风险就从“知识过期”变成“规则被改错了”,那可就是事故了。当然官方也说明白:知识图谱已上线,本体和 LLM Wiki 还在建设中。这次发布,一半是能用的,一半还没做完。
腾讯云副总裁吴运声在发布会上说过一句话,笔者觉得是整场发布里最实在的一句:
“很多时候,AI 出错并不是因为模型不够聪明,而是因为它拿到的知识本身就有问题。”
这句话放在人身上同样成立。一个员工答错客户问题,八成不是他不努力,是他手上那版制度过期了。
所以“知识治理”这件事,是被 AI 硬生生从可选项逼成了必选项。乐享今年还发了份《知识治理五级成熟度模型》,把治理分成主动发现、自动处理、智能决策、持续优化、自主演进五档,目前 K1 到 K4 的能力已经落地。企业拿它当尺子量自己到哪一步了——这个思路挺聪明,卖工具之前先卖标准。
六、笔者的一点判断
写到这里吧,说三点自己的看法。
- “知识库”这个词快撑不住了。 它的边界已经从“存文档”扩到了“给 Agent 供上下文”。名字没变,品类变了。以后评价一个知识库,标准不再是“好不好搜”,而是“Agent 用起来靠不靠谱”。
- 护城河不在模型,在治理和权限。 模型谁都能接啊,今天 DeepSeek,明天 Kimi,后天 GLM。真正难抄的是四级权限(企业、团队、知识库、单篇)、全链路审计、回滚、密级管理这些东西——它们不酷,但它们是企业敢把知识交给 AI 的前提。东阳光三万人、九个知识库、六万多份文件铺下去,靠的就是这套秩序;中信建投拿 22 万余篇知识撑起 44 个垂域场景,OPPO 把知识问答的 AI 拦截率从 70% 提到 77%,靠的都不是更贵的模型。
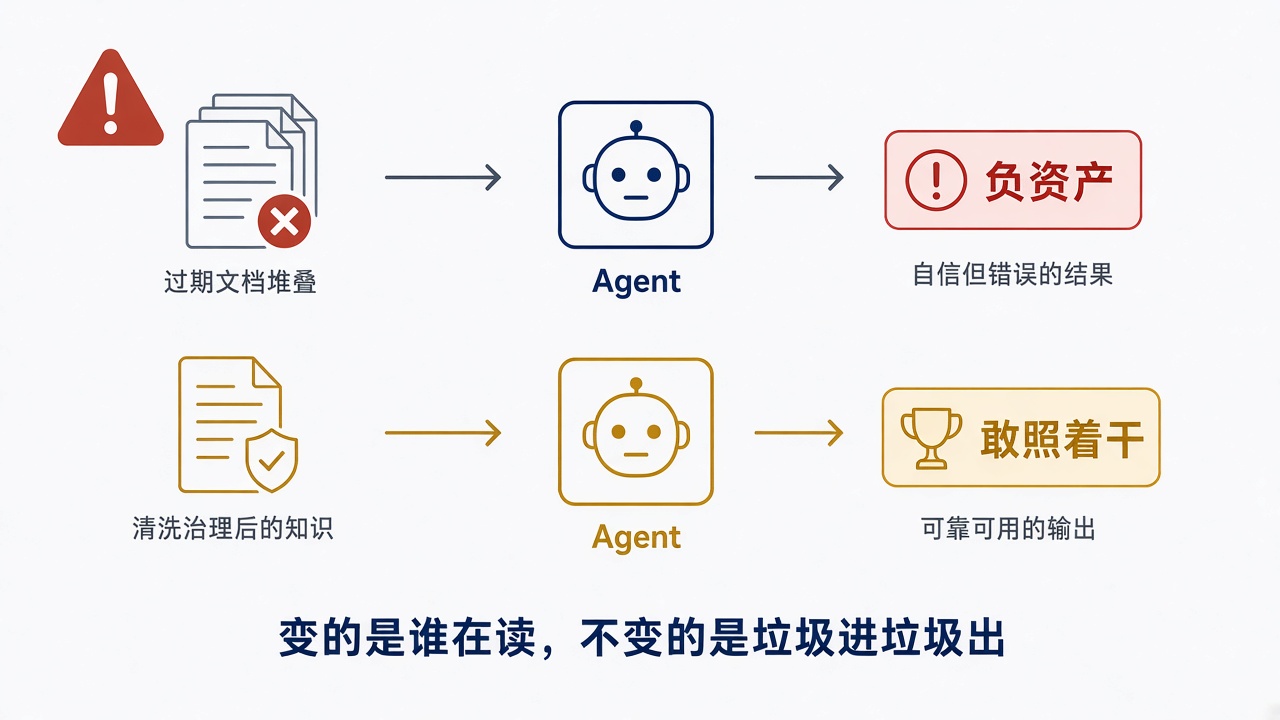
- 最大的风险是“看起来很美”。 知识库上线很容易,让人愿意写很难,让 Agent 敢用更难。一个塞满过期文档的库,对 Agent 来说是负资产——它会错得比“不知道”更快、更自信。正大康地把 27 个团队的空间、16000 多篇文档梳理成体系之后,课件制作从 5 天压到 1 小时;反过来,一个没人梳理过的库,上线得越快,烂得越快。
顺带说一句,弗若斯特沙利文今年上半年的《中国企业级 AI 知识库市场研究报告》把乐享排在综合竞争力首位。这种厂商买单出的报告,看看就好,但方向没错——大家比的就是治理和权限,不是谁接的模型更贵。
18 年前,腾讯做 KM,是为了让员工愿意分享;18 年后,做知识中枢,是为了让 Agent 敢照着干。
变的从来是“谁在读”,不变的是那句老话——垃圾进,垃圾出。
最后留个问题:你们公司的知识库,现在是给人看的,还是给 Agent 用的?